내가 가져갈 핵심 한 줄
깨끗한 데이터는 저차원 manifold 위에 있지만 노이즈·velocity는 고차원 전체에 퍼져 있으므로, 네트워크가 (깨끗한 이미지)를 직접 예측하게 하면 hidden 차원보다 큰 패치(768~12288-d)도 처리할 수 있다 — 그래서 tokenizer·사전학습·보조 손실 없이 픽셀 위의 plain ViT만으로 diffusion이 된다.
분야: generative-models · computer-vision · 핵심 개념: prediction-target, diffusion-transformer, diffusion-model, flow-matching, rectified-flow, latent-diffusion-model
원문 범위·표기
읽은 PDF는 CVPR 2026 Open Access 본문(11쪽, 인쇄 쪽 36115–36125, 참고문헌 포함)이며 부록은 포함되어 있지 않다 (본문이 “see appendix”로 미루는 noise scaling·in-context token 수·EDM 비교 등은 확인 불가). 쪽 번호
p.N은 PDF 물리 페이지. 시간 규약: → 노이즈, 데이터 (2023-rectified-flow·2023-flow-matching과 같고 2024-sd3와 반대).
문제·동기
- Diffusion은 원래 “깨끗한 이미지를 예측하는 denoising”이었지만, 실제로는 ε-prediction(2020-ddpm)과 v-prediction(flow)이 표준이 되면서 네트워크가 노이즈 또는 노이즈 섞인 양을 예측하게 되었다 (§1, p.1).
- 손실 가중치만 바꾸면 /ε/v 예측은 서로 변환 가능하다는 이유로, “네트워크가 무엇을 직접 출력하는가”는 덜 주목받았다 (§1, p.1).
- Manifold 가정: 자연 이미지는 고차원 픽셀 공간의 저차원 manifold 위에 있지만, 노이즈 ε와 velocity 은 본질적으로 off-manifold다 (§1, Fig. 1, p.1). 고차원 노이즈를 예측하려면 노이즈 정보를 전부 보존할 큰 용량이 필요하지만, 깨끗한 데이터는 저차원 정보만 남기면 되므로 제한된 용량으로도 예측 가능하다 (§1, p.1–2).
- latent 공간은 이 어려움을 “해결한 게 아니라 숨긴” 것이고, pretrained tokenizer 의존으로 diffusion이 self-contained하지 않다 (§1, p.2). 픽셀 diffusion은 dense conv·작은 패치·채널 증가·long skip으로 정보 병목을 피해 왔는데, 이는 고차원 noised quantity를 예측해야 했기 때문이라고 본다 (§1, p.2).
- ViT식 diffusion은 토큰당 차원이 커지면 픽셀·latent 모두에서 급격히·파국적으로 무너진다는 보고가 반복되었다 (§2 “High-dimensional Diffusion”, p.3).
핵심 아이디어·방법
1. 예측 공간 vs 손실 공간 — 9가지 조합 (§3.1–3.2, Table 1)
- 선형 schedule (Eq. 1), (Eq. 2), flow 손실 (Eq. 3), 샘플링은 를 50-step Heun으로 풂 (Eq. 4, §3.1, p.3). logit-normal (2024-sd3) (§3.1).
- “x/ε/v-prediction”은 네트워크의 직접 출력이 각각 일 때만 부른다. 하나를 예측하면 Eq. 1–2로 나머지 둘을 계산할 수 있다 — 예: -pred이면 , (Eq. 5, Table 1, §3.2, p.4).
- 손실은 어느 공간에서든 정의 가능하고, 공간을 바꾸는 것은 손실 재가중과 같다. 예: -pred + v-loss (§3.2, p.4). 3 예측 × 3 손실 = 9 조합, 이 중 수학적으로 같은 것은 없다 (§3.2, p.4–5). 어떤 조합이든 v로 변환해 같은 ODE로 샘플링 가능 (§3.2 “Generator Space”, p.5).
| 손실 \ 직접 출력 | (a) -pred | (b) ε-pred | (c) v-pred | 출처 |
|---|---|---|---|---|
| (1) x-loss | Table 1 | |||
| (2) ε-loss | Table 1 | |||
| (3) v-loss | Table 1 |
2. Toy 실험 — 고차원에 묻힌 저차원 데이터 (§3.3, Fig. 2)
- 2차원 나선 데이터를 고정된 무작위 column-orthogonal 행렬 로 차원에 묻고, 256-d hidden 5층 ReLU MLP로 생성 학습(모두 v-loss) (§3.3, p.4–5).
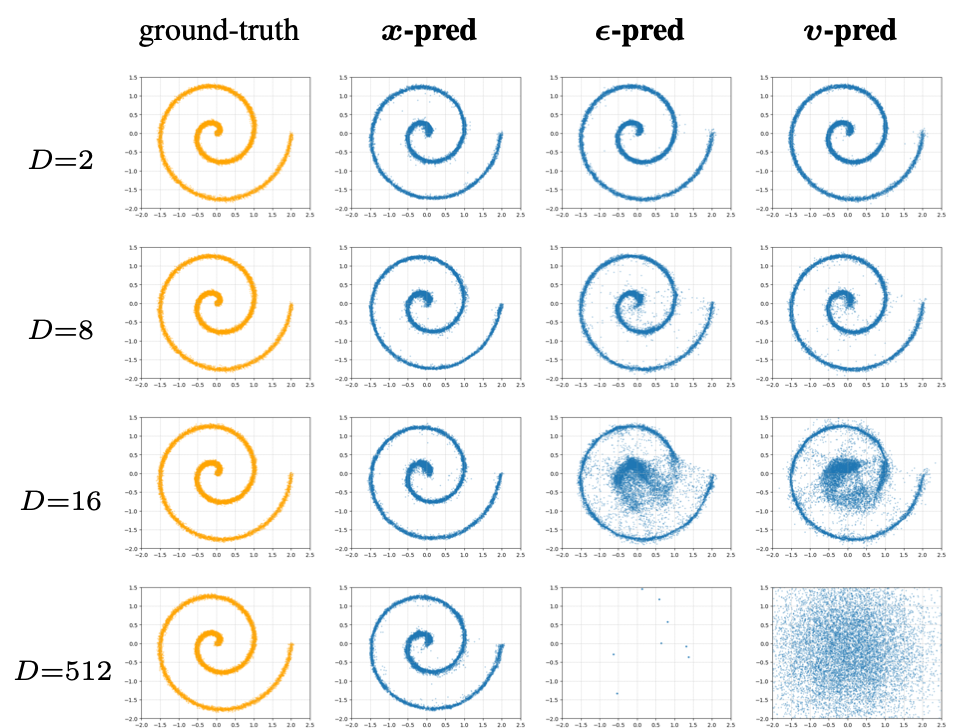 Figure 2. 관측 차원 (행)에서 정답(주황)과 /ε/v-prediction(파랑)의 생성 결과. 부터 ε·v-pred는 나선이 뭉개지고, MLP 폭(256)보다 큰 에서는 ε-pred의 점이 플롯 범위에 거의 남지 않고 v-pred는 노이즈 구름이 되지만, -pred는 모든 에서 나선을 유지 — 출처: Li & He, 2026, Fig. 2 (arXiv)
- -pred는 MLP가 under-complete( > 256)여도 잘 된다: 이상적인 출력이 암묵적으로 차원이기 때문 (§3.3, p.5).
3. JiT 아키텍처 — “Just image Transformers” (§4.1, Fig. 3)
- 이미지를 비중첩 패치로 나눠 선형 임베딩 + positional embedding → Transformer 블록 → 선형 예측기로 패치()를 복원. 시간·클래스 조건은 adaLN-Zero. 즉 DiT를 픽셀 패치에 그대로 적용한 것 (§4.1, p.5, Fig. 3).
- JiT/16(256², 패치 768-d), JiT/32(512², 3072-d) (§4.1, p.5). 1024²에서는 JiT/64(12288-d) (Table 5).
- 최종 알고리즘 = -prediction + v-loss (Table 1 (3)(a)): , (Eq. 6, §4.3, p.7). 의 분모는 0.05로 clip (§4.3). Algorithm 1(학습)·2(Euler 샘플링) (p.7).
- Bottleneck 패치 임베딩: 선형 임베딩을 차원으로 줄였다 늘리는 두 선형층(저랭크)으로 바꿈 (§4.2 “Bottleneck can be beneficial”, p.6, Fig. 4).
- “Just Advanced” Transformer: 언어모델용 범용 개선 SwiGLU, RMSNorm, RoPE, qk-norm과 여러 개(기본 32개)의 in-context class token을 추가 (§4.4, p.7, Table 4).
주요 결과
무엇을 예측하는가 — 9 조합 (Table 2, p.6; FID-50K, 200 epoch, CFG)
| 손실 | -pred | ε-pred | v-pred | 설정 | 출처 |
|---|---|---|---|---|---|
| x-loss | 10.14 | 379.21 | 107.55 | ImageNet 256², JiT-B/16 (768-d/패치) | Table 2(a) |
| ε-loss | 10.45 | 394.58 | 126.88 | 〃 | Table 2(a) |
| v-loss | 8.62 | 372.38 | 96.53 | 〃 | Table 2(a) |
| x-loss | 5.76 | 6.20 | 6.12 | ImageNet 64², JiT-B/4 (48-d/패치) | Table 2(b) |
| ε-loss | 3.56 | 4.02 | 3.76 | 〃 | Table 2(b) |
| v-loss | 3.55 | 3.63 | 3.46 | 〃 | Table 2(b) |
- 패치가 hidden(768)과 같은 768-d이면 -pred만 동작하고 ε/v-pred는 손실 공간과 무관하게 파국적으로 실패한다 (§4.2 “x-prediction is critical”, p.5, Table 2(a)).
- 패치가 48-d로 hidden보다 훨씬 작으면 9 조합 모두 무난하고 차이는 작다 → 기존 latent diffusion은 입력 차원이 작아 이 문제에 노출되지 않았다 (§4.2, p.5, Table 2(b)).
- 손실 가중만으로는 부족: ε/v-pred는 어떤 손실 공간(= 다른 유효 가중)에서도 실패하고, -pred는 세 손실 모두에서 동작한다. v-loss가 유도하는 가중이 선호되지만 결정적이지 않다 (§4.2 “Loss weighting is not sufficient”, p.5–6).
Noise-level shift (Table 3, p.6) — logit-normal μ로 노이즈 수준 조절
| -pred | ε-pred | v-pred | 출처 | |
|---|---|---|---|---|
| 0.0 (낮은 노이즈) | 14.44 | 464.25 | 120.03 | Table 3 |
| −0.4 | 9.79 | 372.91 | 109.93 | Table 3 |
| −0.8 | 8.62 | 372.36 | 96.53 | Table 3 |
| −1.2 (높은 노이즈) | 8.99 | 355.25 | 106.85 | Table 3 |
- 적절히 높은 노이즈는 이미 잘 되는 -pred에 도움이 되지만, ε/v-pred의 실패는 노이즈 shift만으로 고칠 수 없다 — 실패 원인은 고차원 정보를 전달하지 못하는 것 (§4.2 “Noise-level shift is not sufficient”, p.6). 이후 256² 실험은 (§4.2).
Bottleneck 임베딩 (Fig. 4, p.6 — JiT-B/16, 원 패치 768-d)
| bottleneck | 16 | 32 | 64 | 128 | 256 | 512 | 없음(768) | 출처 |
|---|---|---|---|---|---|---|---|---|
| FID-50K | 9.40 | 8.38 | 7.35 | 7.48 | 7.89 | 8.15 | 8.62 | Fig. 4 |
- 16-d까지 줄여도 파국적 실패가 없고, 32~512 범위의 bottleneck은 최대 약 1.3 FID 개선 (§4.2, p.6, Fig. 4). 고전 manifold learning의 bottleneck 관찰과 맞닿는다 (§4.2).
- hidden 폭을 패치 차원 이상으로 늘리는 것은 필요하지 않다: 3072-d·12288-d 패치에서도 B/L/H 모델이 노이즈만 비례 조정(512에서 2×, 1024에서 4×)하고 동작 (§4.2 “Increasing hidden units is not necessary”, p.6–7).
Just Advanced Transformer (Table 4, p.7 — 256², bottleneck 128-d, 괄호는 CFG interval 적용)
| 구성 | JiT-B/16 | JiT-L/16 | 출처 |
|---|---|---|---|
| Baseline (SwiGLU, RMSNorm) | 7.48 (6.32) | — | Table 4 |
| + RoPE, qk-norm | 6.69 (5.44) | — | Table 4 |
| + in-context class tokens | 5.49 (4.37) | 3.39 (2.79) | Table 4 |
- SwiGLU·RMSNorm을 빼면 7.48 → 7.89로 약간 나빠진다 (p.7 각주 5).
고해상도·스케일링 (Table 5–6, p.7)
| 해상도 | 모델 | 패치 차원 | hidden | 파라미터 | Gflops | FID | 출처 |
|---|---|---|---|---|---|---|---|
| 256² | JiT-B/16 | 768 | 768 | 131M | 25 | 4.37 | Table 5 |
| 512² | JiT-B/32 | 3072 | 768 | 133M | 26 | 4.64 | Table 5 |
| 1024² | JiT-B/64 | 12288 | 768 | 141M | 30 | 4.82 | Table 5 |
| FID-50K (200 → 600 epoch) | B | L | H | G | 출처 |
|---|---|---|---|---|---|
| 256², /16 | 4.37 → 3.66 | 2.79 → 2.36 | 2.29 → 1.86 | 2.15 → 1.82 | Table 6 |
| 512², /32 | 4.64 → 4.02 | 3.06 → 2.53 | 2.51 → 1.94 | 2.11 → 1.78 | Table 6 |
- 패치 크기를 해상도에 비례시켜 시퀀스 길이(16×16)를 고정하므로 512²·1024²도 연산량이 256²과 거의 같다 (§5, p.7, Table 5). 모델이 클수록 256과 512의 FID 차이가 줄고, JiT-G는 512²가 오히려 낮다 — 저자는 큰 모델의 ImageNet FID가 과적합에 좌우되고 512² denoising이 더 어려워 과적합이 덜하다고 해석 (§5 “Scalability”, p.7).
기존 방법과 비교 (Table 7–8, p.8 — FID-50K / IS, “pre-training” = 필요한 외부 모델)
| 방법 (ImageNet 256²) | 외부 사전학습 | 파라미터 | Gflops | FID ↓ | IS ↑ | 출처 |
|---|---|---|---|---|---|---|
| DiT-XL/2 | SD-VAE, VGG | 675+49M | 119 | 2.27 | 278.2 | Table 7 |
| REPA, SiT-XL/2 | SD-VAE, VGG, DINOv2 | 675+49M | 119 | 1.42 | 305.7 | Table 7 |
| RAE, DiT^DH-XL/2 | RAE, VGG, DINOv2 | 839+415M | 146 | 1.13 | 262.6 | Table 7 |
| ADM-G (픽셀) | — | 554M | 1120 | 4.59 | 186.7 | Table 7 |
| SiD2, UViT/1 (픽셀) | — | N/A | 653 | 1.38 | — | Table 7 |
| PixelFlow, XL/4 (픽셀) | — | 677M | 2909 | 1.98 | 282.1 | Table 7 |
| PixNerd, XL/16 (픽셀) | DINOv2 | 700M | 134 | 2.15 | 297 | Table 7 |
| JiT-H/16 (픽셀) | — | 953M | 182 | 1.86 | 303.4 | Table 7 |
| JiT-G/16 (픽셀) | — | 2B | 383 | 1.82 | 292.6 | Table 7 |
| 방법 (ImageNet 512²) | 외부 사전학습 | Gflops | FID ↓ | 출처 |
|---|---|---|---|---|
| DiT-XL/2 | SD-VAE, VGG | 525 | 3.04 | Table 8 |
| RAE, DiT^DH-XL/2 | RAE, VGG, DINOv2 | 642 | 1.13 | Table 8 |
| SiD2, UViT/2 (픽셀) | — | 653 | 1.48 | Table 8 |
| PixNerd, XL/16 (픽셀) | DINOv2 | 583 | 2.84 | Table 8 |
| JiT-G/32 (픽셀) | — | 384 | 1.78 | Table 8 |
- JiT는 외부 모델(tokenizer·perceptual loss·self-supervised 표현) 없이 plain Transformer만 쓰고, 해상도를 두 배로 올려도 연산이 제곱으로 늘지 않는다 (§5 “Reference results”, p.8).
- (해석) 절대 FID는 latent+DINOv2 계열(RAE 1.13)이나 SiD2(1.38)보다 높다. JiT의 강점은 “외부 사전학습 없음 + 적은 Gflops” 조건에서의 경쟁력이다.
한계
- 손실·예측 공간 분석은 선형 schedule 하나로 진행했다 (§3.1, 각주 1 — 저자는 다른 schedule에도 적용 가능하다고 주장). (해석) EDM식 pre-conditioning과의 정량 비교는 부록에 있어 이번 PDF로는 확인 불가.
- manifold 가정에 근거한 설명은 toy(Fig. 2)와 ImageNet 경험 결과로 뒷받침될 뿐, 이론적 증명은 없다 (§3.3, §6) (해석).
- 실험은 ImageNet class-conditional에 한정되고 텍스트 조건·비디오·다른 도메인은 다루지 않는다. 과학 데이터(단백질·분자·날씨)로의 일반화는 기대로만 제시 (§1, §6).
- 최고 수치는 600 epoch·CFG·CFG interval에 의존 (Table 4–6). 추가 손실·사전학습을 쓰면 더 좋아질 수 있으나 미래 과제로 남김 (§5, p.8).
- 분모를 0.05로 clip하는 수치 처리가 필요 (§4.3, p.7) — (해석) 근처 v 재구성이 불안정하다는 뜻.
- 고해상도에서 노이즈를 해상도에 비례해 키우는 조정은 여전히 필요 (§4.2, p.7).
내 연구와의 연결
- (해석) 3D 의료 영상(CT/MRI) 생성: 볼륨은 픽셀 공간 차원이 매우 크고 좋은 3D tokenizer를 구하기 어렵다. -prediction + 큰 3D 패치 + bottleneck 임베딩이면 VAE 없이 볼륨 위에서 직접 diffusion을 시도할 수 있다 — tokenizer 설계가 어려운 도메인에 유리하다는 저자의 주장(§6)과 정확히 맞는다.
- (해석) 분할·복원과의 연결: 의료 영상 복원·분할은 원래 깨끗한 신호(마스크·영상)를 출력하는 문제라 -pred가 자연스럽다 (§2 “x-prediction”에서 restoration 언급). diffusion 기반 분할 모델의 출력 parameterization을 ε → x로 바꾸는 실험이 바로 가능하다.
- (해석) 로보틱스 행동 생성: action chunk처럼 차원이 큰 출력을 flow로 생성할 때도 “네트워크 폭 < 출력 차원”이면 (clean action) 예측이 유리할 수 있다 — flow policy 설계 시 확인할 가설.
- (해석) 우리 쪽 모델에서 ε/v 예측이 고해상도에서 이유 없이 불안정했다면, 먼저 “토큰당 차원 vs hidden 폭”을 점검해 볼 것.
관련 논문
- builds-on: 2023-rectified-flow — 선형 schedule , , v-loss와 ODE 샘플링 (§3.1, Eq. 1–4)
- builds-on: 2023-flow-matching — flow 기반 정식화(v-space 손실)를 출발점으로 사용 (§3.1, Eq. 3)
- builds-on: 2024-sd3 — logit-normal timestep 샘플러(§3.1, Table 3의 shift), 예측 공간 간 변환 유도의 선행 사례 (§3.2)
- builds-on: 2023-dit (미수록) — adaLN-Zero 조건화, “DiT를 픽셀 패치에 적용”한 구조 (§4.1); latent 비교 baseline DiT-XL/2 (Table 7–8)
- builds-on: 2021-vit (미수록) — patch 기반 plain ViT(B/L/H 크기 정의 포함) (§4.1–4.2)
- builds-on: 2021-cfg — 모든 실험에 CFG 사용, CFG interval 추가 (Table 2–6, §4.3)
- compares-with: 2020-ddpm — -prediction은 DDPM 코드에도 있었으나 DDPM은 ε-prediction이 훨씬 낫다고 보고했다; 본 논문은 저차원(64², 48-d 패치)에서는 차이가 작고 고차원에서만 -pred가 결정적임을 보임 (§2 “x-prediction”, Table 2)
- compares-with: 2022-ldm — latent diffusion을 “1단계 autoencoder로 manifold learning + 2단계 diffusion”으로 해석하고, latent 의존 없는 픽셀 diffusion을 지향. SD-VAE 기반 latent 방법들과 수치 비교 (§2 “Manifold Learning”, §1, Table 7–8)
- compares-with: 2022-progressive-distillation (미수록) — Salimans & Ho의 v-prediction·손실 가중×예측 조합 탐색(CIFAR-10)과 대비: 고차원에서는 가중만으로 설명되지 않음 (§2, §4.2, 각주 3)
- compares-with: 2022-edm (미수록) — EDM의 pre-conditioned 출력도 데이터와 노이즈를 섞은 양이라는 점에서 대비 (§2; 정량 비교는 부록)
- compares-with: 2025-sid2 (미수록) — 픽셀 diffusion SOTA(SiD2 UViT/1 FID 1.38, 653 Gflops) 대비 JiT-G/16 1.82 (383 Gflops) (Table 7)